本文转载自我在 CSDN 的旧博客:算法——冒泡排序(写于 2018-02-19),迁移时整理了格式。
我们学习排序算法时,最先学习的一定有冒泡排序。它最简单、好理解,所以再不考虑复杂度的情况下也是很常用的排序算法(我经常用 毕竟 两个 for 嵌套 一个 swap 嘛,很好记)接下来我们来看看它的算法思路。
先不谈别的,先谈一谈为什么叫冒泡排序。
我们来看《啊哈!算法》中萌萌的插图,方便理解。
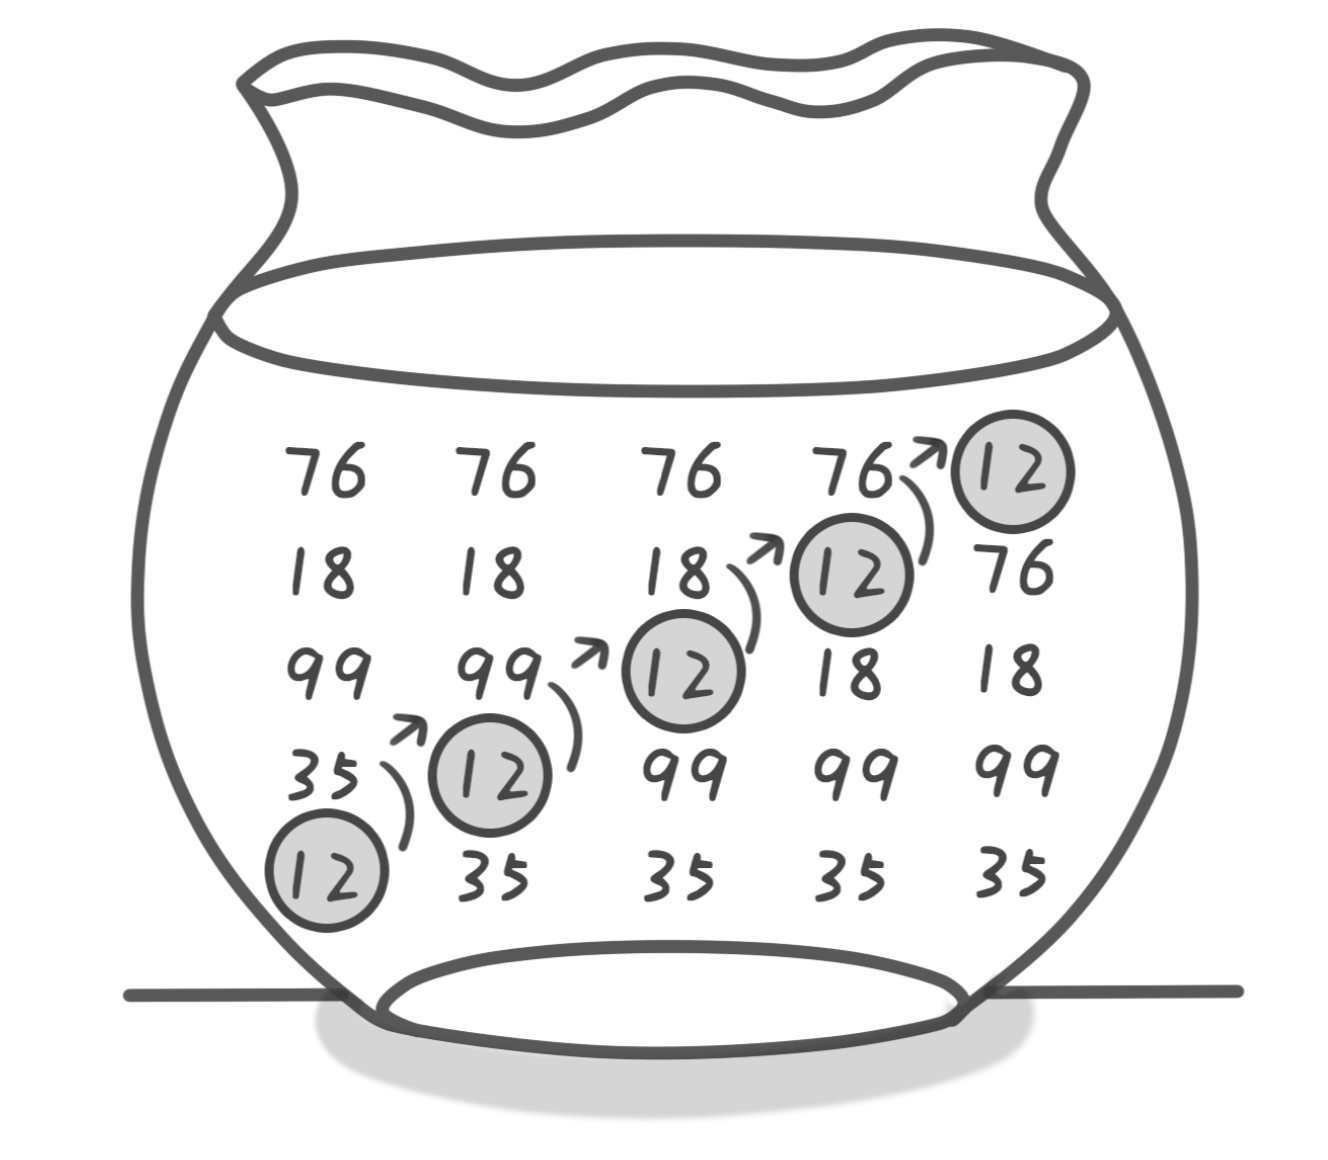
想象数组中的数无序排列,每个数就好似水中的气泡。比较相邻两个气泡(数)的大小,此时暂定数组为{12,35,99,18,76},所以一开始比较的是 12 和 35,发现 35 比 12 大,所以 12 浮了上去(12 与 35 互换位置 swap)。如图,完成一趟操作后,12 浮到了水面(排在了最前面),接下来只用循环操作即可,循环时考虑到排过的就不排了,所以之后每次循环比较的次数都会-1。其实不管浮到水面还是沉到水底,都是一个意思。
说专业一点:
(1)比较相邻的前后两个数据,如果前面数据大于后面的数据,就将两个数据交换;
(2)这样对数组的第 0 个数据到 N-1 个数据进行一次遍历后,最大的一个数据就到了最后一个位置,也就是下标为 N-1 的位置(沉到了水底)。
(3)N = N-1,如果 N 不为 0 就重复(1)(2)两步,否则排序完成,也就是对数组的第 0 个数据到 N-2 个数据再次进行遍历;
代码如下:
#include <stdio.h>

void Swap(int*, int*);
void BubbleSort(int*, int);

//交换两个数的值
void Swap(int *a, int *b){
    int temp;
    temp = *a;
    *a = *b;
    *b = temp;
}

//冒泡排序
void BubbleSort(int arr[], int len){
    for(int i = 0; i < len; i++){
        for(int j = 1; j < len - i; j++){
            if(arr[j-1] > arr[j]){
                Swap(&arr[j-1], &arr[j]);
            }
        }
    }
}

int main(){
    int array[5] = {12,35,99,18,76};
    BubbleSort(array,5);
    for(int i = 0; i < 5; i++){
        printf("%d ",array[i]);
    }//会输出12 18 35 76 99
    return 0;
}
熟记冒泡排序,在很多不考虑复杂度的情况下能很快完成排序代码的编写(当然直接包含算法库,调用 sort() 更快…)
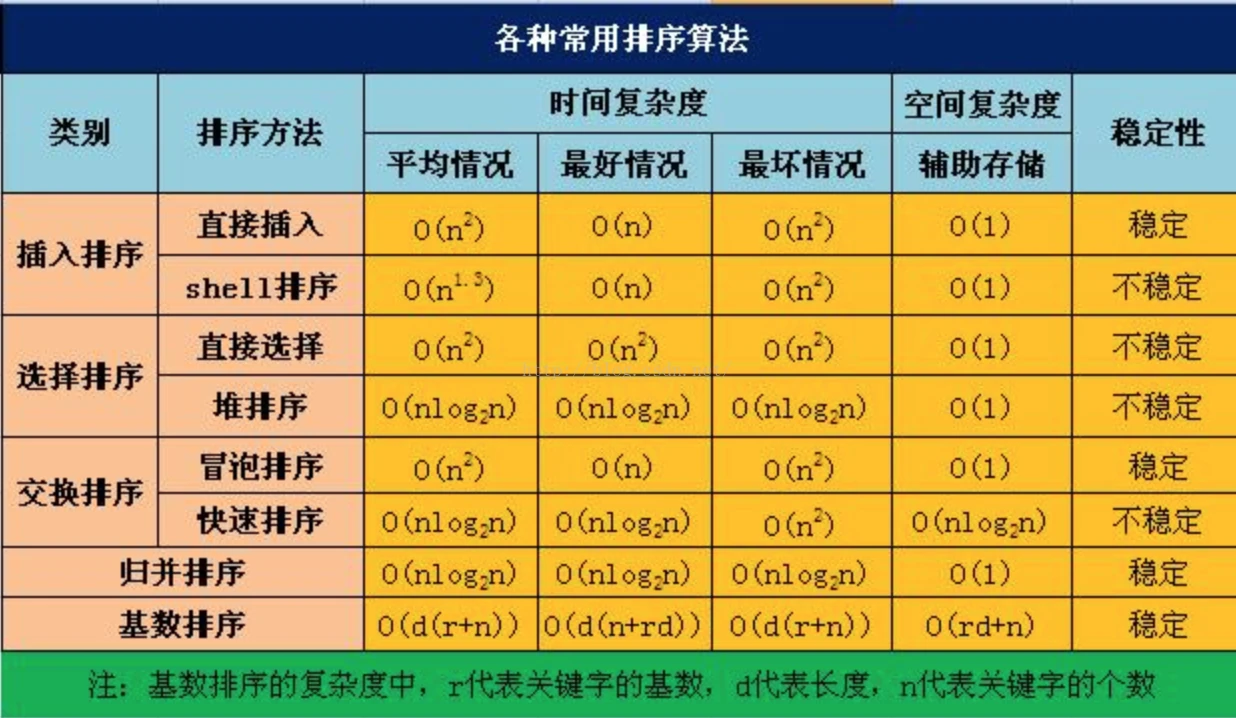
借用一张图,方便大家对比:
留言